배경: 왜 하필 Cloud Run이었을까
사내 위키에 쌓인 문서 수만 건을 BigQuery로 옮겨야 하는 일이 생겼습니다. 단순히 텍스트만 옮기는 작업은 아니었습니다. HTML 본문을 마크다운으로 깔끔하게 바꾸고, 거기에 LLM 요약까지 덧붙여 데이터 카탈로그에 등록해야 했습니다.
처음에는 어디서 이 작업을 돌릴지부터 고민이었습니다.
하루에 고작 한두 번 도는 배치입니다. 이걸 위해 GCE 가상머신을 24시간 내내 켜두자니 비용이 아까웠고, Airflow 같은 무거운 워크플로우 도구를 새로 구축하자니 배보다 배꼽이 더 컸습니다.
그래서 눈을 돌린 곳이 Cloud Run이었습니다. 컨테이너만 말아 올리면 끝이고, 코드가 도는 시간만큼만 돈을 내면 되니까요.
하지만 막상 문서 수만 건을 실제로 밀어 넣어 보니 예상치 못한 벽에 부딪혔습니다. 서버리스는 기본적으로 '짧고 가벼운 웹 요청'을 처리하도록 만들어진 환경이기 때문입니다. 현장에서 겪었던 세 가지 문제와 그 시행착오를 적어 봅니다.
1. 끝없이 걸리는 배치, 시간을 쪼개 이어달리기
가장 먼저 발목을 잡은 건 Cloud Run 타임아웃 제한이었습니다.
Cloud Run은 기본 타임아웃이 5분이고, 설정을 끝까지 늘려도 최대 60분이 한계입니다. 문서 몇백 건을 테스트할 때는 아무 문제가 없었지만, 수만 건을 수집하면서 느린 LLM API 응답까지 기다리다 보니 60분도 턱없이 부족했습니다.
그렇다고 타임아웃 설정만 무작정 최대로 늘리는 건 위험했습니다. 외부 API가 먹통이 되었을 때 컨테이너가 한 시간 내내 공회전하며 비용만 태울 수 있기 때문입니다.
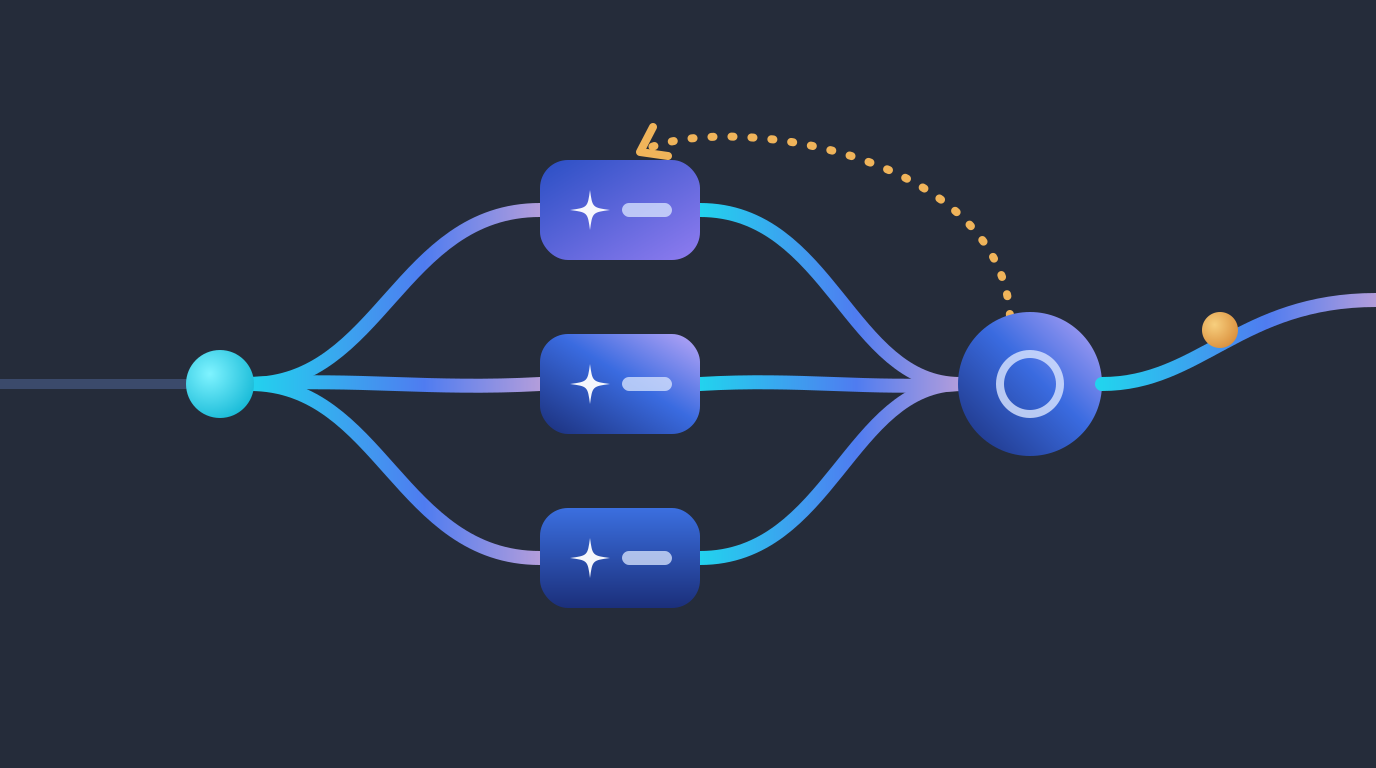
고민 끝에 작업을 한 번에 끝내려는 생각을 버렸습니다. 대신 컨테이너 하나가 달릴 수 있는 **'시간 예산(Time Budget)'**을 정해두고 이어달리기를 시키기로 했습니다.
방식은 단순합니다. 배치가 시작될 때 시계를 켜고, 약속된 시간(예: 8분)이 지나면 하던 일을 멈춥니다. 그리고 방금 몇 번째 문서까지 처리했는지(next_start_index)만 적어둔 채, **자기 자신의 URL을 비동기로 다시 호출(Self-Invocation)**하고 퇴장하는 것입니다.
def execute_batch(pages: list[str], start_index: int, time_budget_sec: int = 480):
    start_time = time.time()

    for idx in range(start_index, len(pages)):
        if time.time() - start_time > time_budget_sec:
            # 약속된 8분이 지나면 바통을 다음 호출로 넘기고 종료
            invoke_self_async(next_start_index=idx)
            return {"status": "RELAYED", "next_index": idx}

        process_single_page(pages[idx])

    return {"status": "COMPLETED"}
Self-Invocation 비동기 호출 구현 상세 (접기/펼치기)
import urllib.request
import requests

def invoke_self_async(next_start_index: int):
    # GCP 인스턴스 메타데이터 서버로부터 ID 토큰 발급
    meta_url = f"http://metadata.google/computeMetadata/v1/instance/service-accounts/default/identity?audience={SELF_URL}"
    req = urllib.request.Request(meta_url, headers={"Metadata-Flavor": "Google"})
    with urllib.request.urlopen(req, timeout=5) as resp:
        id_token = resp.read().decode("utf-8")

    # 타임아웃을 극도로 짧게(0.1초) 주어 호출만 날리고 즉시 제어권 반환
    headers = {"Authorization": f"Bearer {id_token}"}
    payload = {"start_index": next_start_index}
    try:
        requests.post(SELF_URL, json=payload, headers=headers, timeout=0.1)
    except requests.exceptions.Timeout:
        pass
여기서 핵심은 다음 주자를 부를 때 응답을 기다리지 않는 것입니다. timeout=0.1을 주어 요청만 던져놓고 바로 연결을 끊어버리면, 앞선 컨테이너는 깔끔하게 종료되고 새 컨테이너가 바통을 이어받아 다음 문서부터 처리를 이어갑니다. 별도의 메시지 큐 하나 없이도 수만 건의 배치가 끊기지 않고 완주하기 시작했습니다.
2. 조용히 차오르던 메모리, 범인은 BeautifulSoup이었다
타임아웃을 해결하고 나니 두 번째 문제가 터졌습니다. 배치가 중반쯤 넘어갈 때마다 컨테이너가 OOM(Out of Memory)을 뿜으며 죽어버리는 현상이었습니다.
처음에는 당황스러웠습니다. 내 노트북에서 샘플 문서 수십 개를 돌릴 때는 메모리 그래프가 미동도 하지 않았기 때문입니다.
원인을 찾다 보니 두 가지 사실이 맞물려 있었습니다. 첫째로 Cloud Run은 요청이 끝나도 컨테이너를 바로 폐기하지 않고 다음 요청에 재사용합니다. 즉, 이전 작업에서 남긴 메모리 찌꺼기가 그대로 다음 작업까지 쌓입니다.
둘째로 파이썬의 가비지 컬렉터(GC)가 BeautifulSoup 객체를 제때 치우지 못해 BeautifulSoup 메모리 누수가 발생하고 있었습니다.
HTML을 파싱해 만든 트리는 부모 태그가 자식 태그를 가리키고, 자식 태그가 다시 부모와 형제 태그를 가리키는 구조입니다. 객체들이 서로의 꼬리를 물고 있는 셈입니다. 파이썬은 기본적으로 참조 횟수가 0이 될 때 메모리를 바로 비우는데, 이렇게 서로를 가리키고 있으면 함수가 끝나도 참조 횟수가 0이 되지 않습니다.
결국 다 쓴 파서 트리는 파이썬에게 맡기지 않고 직접 부숴버려야 했습니다.
soup = BeautifulSoup(raw_html, "html.parser")
markdown_content = convert_to_markdown(soup)

# 서로 물고 있는 노드 연결고리를 즉시 끊고 메모리에서 제거
soup.decompose()
del soup
del raw_html
soup.decompose() 한 줄이 결정적이었습니다. 트리 안의 태그 연결고리를 강제로 다 끊어주니 del을 호출하는 즉시 메모리가 반환되었습니다. 여기에 묶음 처리가 끝날 때마다 gc.collect()를 한 번씩 호출해 주자, 치솟던 피크 메모리가 60% 넘게 뚝 떨어졌고 더 이상 컨테이너가 죽지 않았습니다.
3. 언제 멈춰도 다시 돌릴 수 있게: Staging과 MERGE
긴 배치를 운영하다 보면 코드가 아무리 완벽해도 외부 요인으로 작업이 실패할 때가 있습니다. 사내 위키 서버가 잠깐 느려지거나 네트워크가 흔들릴 수도 있으니까요.
이때 가장 피하고 싶었던 상황은 **"배치가 중간에 죽어서 다시 돌렸더니, 아까 들어간 데이터가 똑같이 한 벌 더 쌓이는 일"**이었습니다.
실패했을 때 사람이 일일이 어디까지 들어갔는지 확인하고 지우는 건 불가능에 가깝습니다. 언제든 마음 편히 재실행 버튼을 누르려면, 같은 배치를 두 번 돌려도 결과 테이블의 상태가 똑같이 유지되는 **멱등성(Idempotency)**이 필요했습니다.
이를 위해 본 테이블에 데이터를 바로 넣지 않고, 임시 대기실 역할을 하는 스테이징(Staging) 테이블을 앞에 두었습니다.
배치가 도는 동안에는 수집한 문서를 일단 스테이징 테이블에 전부 쏟아붓습니다. 그리고 마지막에 BigQuery MERGE 문을 딱 한 번 실행해 본 테이블과 합칩니다.
MERGE `my_project.dataset.documents` T
USING `my_project.dataset.documents_staging` S
ON T.DOC_ID = S.DOC_ID
WHEN MATCHED AND S.VERSION > T.VERSION THEN
  UPDATE SET
    TITLE = S.TITLE,
    CONTENT = S.CONTENT,
    UPDATED_AT = S.UPDATED_AT
WHEN NOT MATCHED THEN
  INSERT (DOC_ID, TITLE, CONTENT, UPDATED_AT)
  VALUES (S.DOC_ID, S.TITLE, S.CONTENT, S.UPDATED_AT)
Staging 테이블 생성 및 MERGE 파이썬 파이프라인 로직 (접기/펼치기)
from google.cloud import bigquery

def sync_staging_to_target(client: bigquery.Client):
    merge_query = """
    MERGE `my_project.dataset.documents` T
    USING `my_project.dataset.documents_staging` S
    ON T.DOC_ID = S.DOC_ID
    WHEN MATCHED AND S.VERSION > T.VERSION THEN
      UPDATE SET
        TITLE = S.TITLE,
        CONTENT = S.CONTENT,
        UPDATED_AT = S.UPDATED_AT
    WHEN NOT MATCHED THEN
      INSERT (DOC_ID, TITLE, CONTENT, UPDATED_AT)
      VALUES (S.DOC_ID, S.TITLE, S.CONTENT, S.UPDATED_AT);
    """
    job = client.query(merge_query)
    job.result()
문서 ID(DOC_ID)를 기준으로 비교해서 아예 없던 문서는 새로 넣고, 이미 있던 문서는 버전(VERSION)이 더 최신일 때만 덮어씁니다. 이렇게 만들어 두니 새벽에 배치가 멈추더라도 걱정할 필요가 없어졌습니다. 그저 처음부터 다시 실행하기만 하면 중복 없이 변경된 문서만 깔끔하게 반영됩니다.
마치며
돌아보면 서버리스로 긴 배치를 돌리는 일은 "가볍게 빌려 쓰는 환경의 한계를 코드의 구조로 메우는 과정"이었습니다.
시간 제한은 8분 단위의 이어달리기로 풀고, 좁은 메모리는 다 쓴 파서 트리를 그 자리에서 해체해 지켰으며, 중간 실패에 대한 불안함은 MERGE 쿼리 하나로 덜어냈습니다. 만약 하루 한두 번 도는 배치 때문에 상시 서버를 띄울지 고민하고 있다면, 이 세 가지 안전장치를 얹어 Cloud Run으로 먼저 가볍게 시작해 보는 것을 추천합니다.
출처 및 참고자료
- Configure request timeout for servicesCloud Run 서비스 요청 타임아웃 기본값과 최대값
- Authenticating service-to-service메타데이터 서버에서 ID 토큰을 받아 자기 자신을 호출하는 방식
- Set task timeout for jobs긴 배치에 대안이 되는 Cloud Run Jobs 태스크 타임아웃
- Data manipulation language (DML) statements in GoogleSQLMERGE 문법
- Beautiful Soup Documentationdecompose()로 트리 해제
- gc — Garbage Collector interface순환 참조와 gc.collect()