이어달리기까지 만들어야 했던 이유
앞선 Cloud Run 배치 글에서 가장 길게 쓴 부분은 타임아웃 이야기였습니다. 문서 수만 건을 처리하는 동안 느린 LLM 응답을 기다리다 보니, 8분마다 바통을 넘기는 이어달리기 구조까지 만들어야 했습니다.
그 LLM 호출이 하는 일을 다시 들여다봤습니다. 크게 두 가지였습니다.
하나는 문서마다 세 줄 요약을 만드는 일. 다른 하나는 문서를 인프라, 데이터, 보안, 기타 중 하나로 분류하는 일이었습니다.
요약은 문서마다 다른 문장을 만들어내야 합니다. 분류는 다릅니다. 답이 넷 중 하나로 정해져 있습니다. 그런데도 우리는 수만 건 전부에 대해 똑같이 거대한 모델을 한 번씩 부르고 있었습니다.
분류는 SQL로 옮길 수 있다
BigQuery에는 이미 SQL 안에서 LLM을 부르는 AI 함수들이 있습니다. 분류라면 AI.CLASSIFY, 참/거짓 필터라면 AI.IF가 맞습니다.
SELECT
  doc_id,
  title,
  AI.CLASSIFY(
    content,
    categories => ['인프라', '데이터', '보안', '기타']
  ) AS topic
FROM `my_project.wiki.documents`
WHERE updated_at >= TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 1 DAY);
이것만으로도 파이썬 쪽 코드가 꽤 줄어듭니다. 재시도, 동시성 제한, 타임아웃 처리를 BigQuery가 대신해 주기 때문입니다.
하지만 비용 문제는 그대로입니다. 내부적으로는 여전히 행마다 모델을 호출하니까요. Next '26에서 이 지점을 겨냥한 발표가 나왔습니다.
최적화 모드: 쿼리 도중에 작은 모델을 만든다
발표 이름은 "SQL 우선 AI 최적화 모드"였습니다. 구글은 AI.CLASSIFY와 AI.IF에서 토큰 소비와 비용을 최대 230배 줄일 수 있다고 주장했습니다.
230배라는 숫자를 보고 처음엔 의심부터 들었습니다. 그래서 동작 방식을 문서에서 찾아 읽었습니다. 생각보다 영리한 구조였습니다.
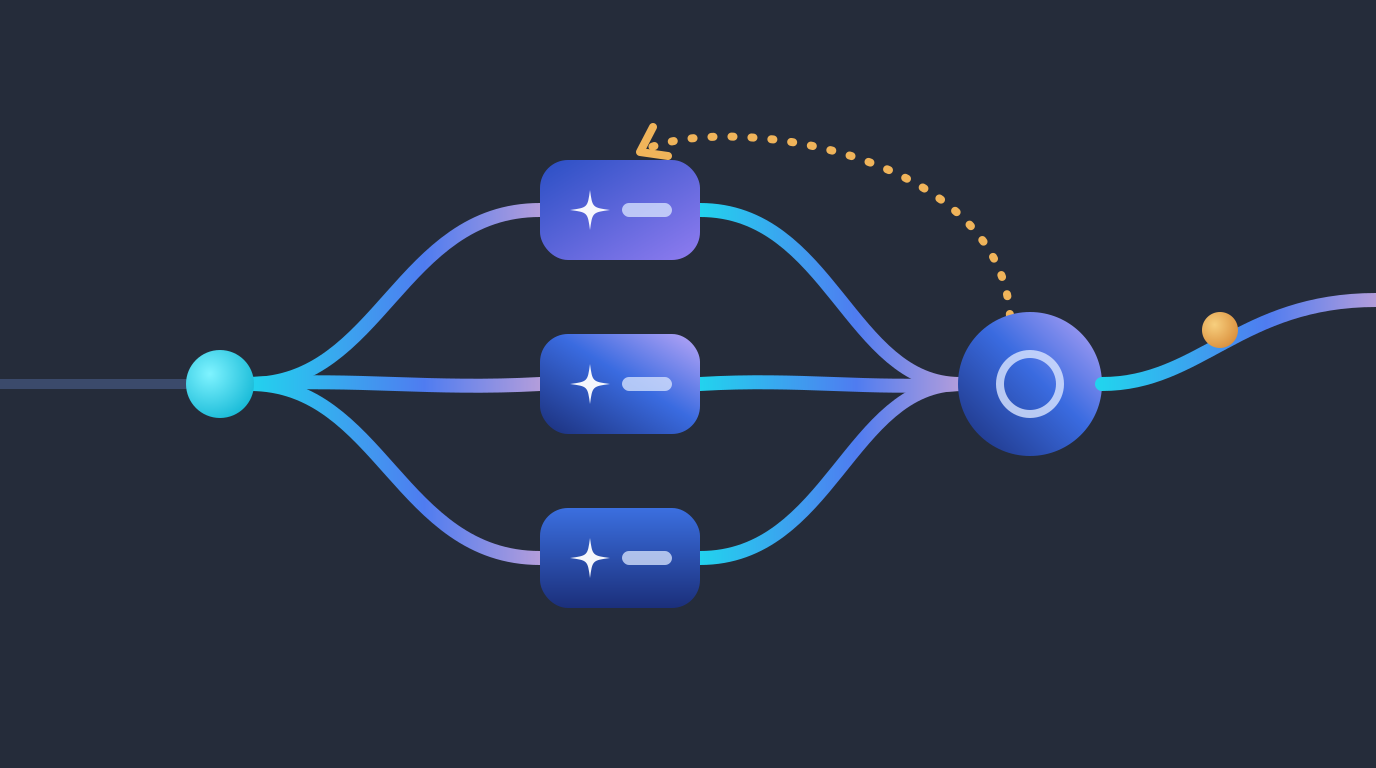
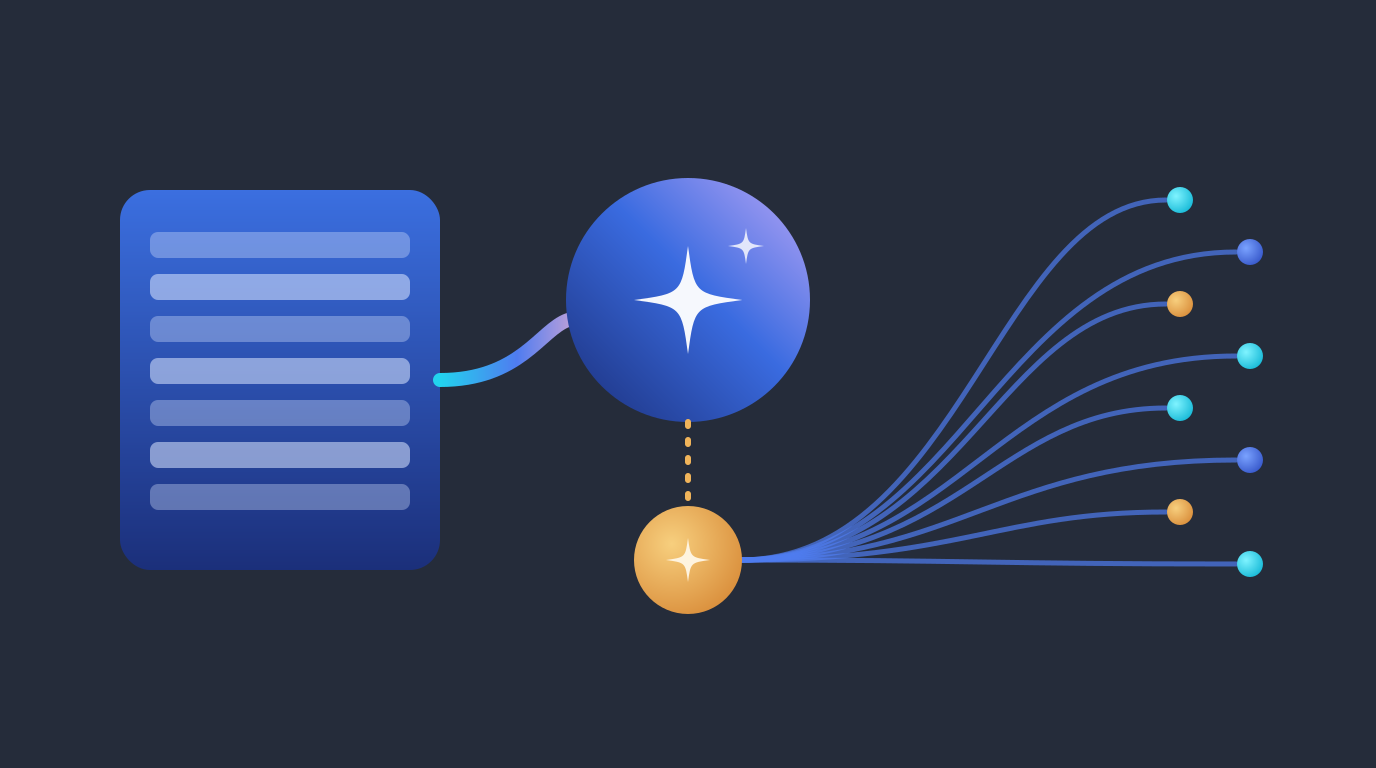
- 쿼리가 시작되면 일부 행만 LLM에게 보내 정답을 받습니다.
- 그 정답과 행의 임베딩으로 작고 가벼운 증류(distilled) 모델을 쿼리 실행 중에 학습시킵니다.
- 나머지 대부분의 행은 이 작은 모델이 처리합니다.
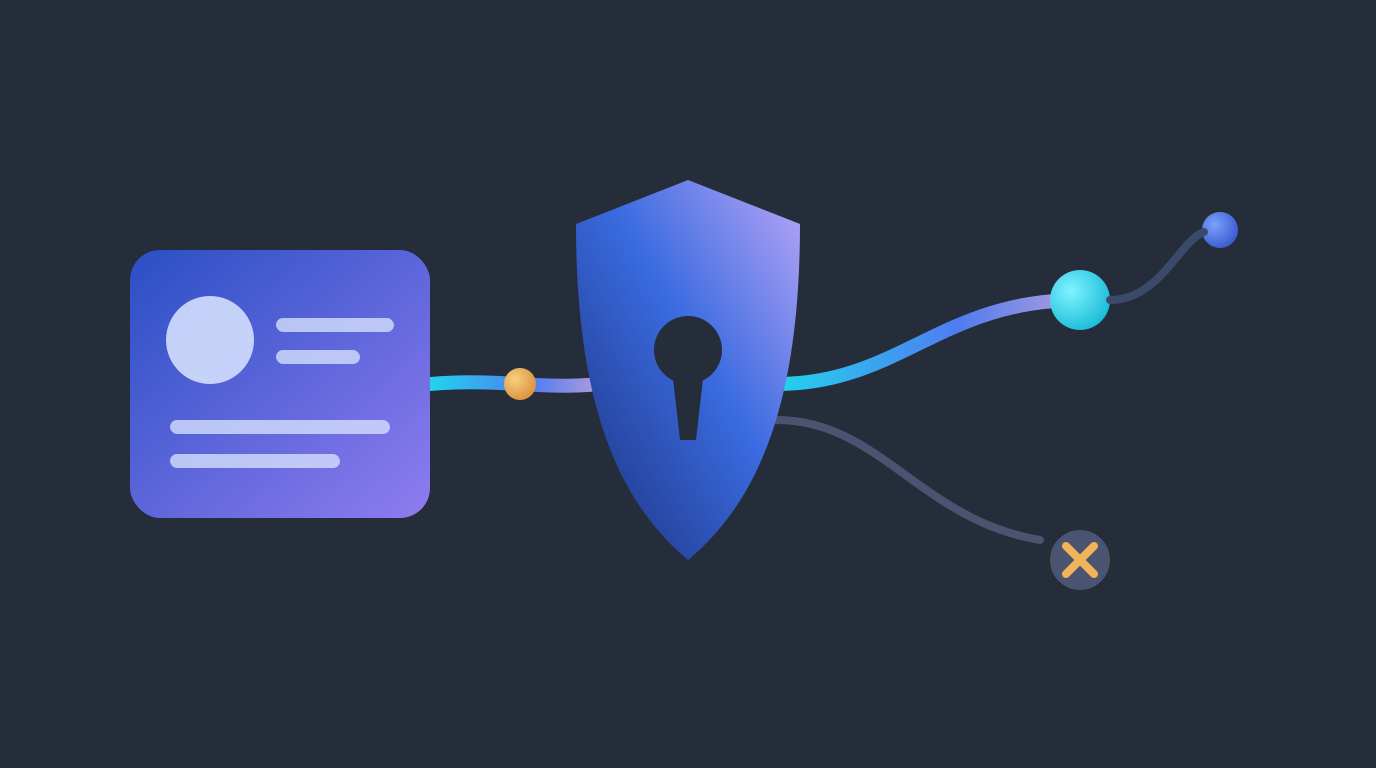
- 작은 모델의 정확도가 LLM 결과 대비 기준에 못 미치면, 쿼리는 기본적으로 실패합니다.
선생님이 문제 몇백 개를 풀어 보여주면, 조교가 그 풀이법을 익혀 나머지 수만 개를 채점하는 그림입니다. 조교 실력이 모자라면 아예 채점을 거부합니다.
마지막 단계가 마음에 들었습니다. 조용히 품질이 떨어지는 대신, 시끄럽게 실패합니다.
쓸 수 없는 경우도 분명하다
문서에 적힌 제약은 우리 상황과 꽤 직접적으로 맞닿아 있었습니다.
- 지원 함수는
AI.IF와AI.CLASSIFY뿐입니다. 요약 같은 생성 작업에는 쓸 수 없습니다. - 학습할 데이터가 있어야 하니 대략 3,000행 이상의 테이블이 대상입니다.
- 하나의 행에 여러 라벨을 붙이는 다중 라벨 분류는 지원하지 않습니다.
- 행마다 임베딩이 필요합니다.
하루치 변경분만 분류하는 증분 배치라면 3,000행이 안 되는 날도 있습니다. 그래서 일일 증분은 일반 모드로, 분기마다 전체 재분류할 때는 최적화 모드로 나누는 방향을 검토하고 있습니다.
다중 라벨 제약도 걸렸습니다. 문서 하나가 데이터이면서 보안인 경우가 실제로 꽤 있기 때문입니다. 이 경우에는 AI.IF로 라벨마다 따로 묻는 방식이 대안이 됩니다.
SELECT
  doc_id,
  AI.IF(('이 문서는 보안·권한 관리에 관한 내용인가요? 문서: ', content)) AS is_security,
  AI.IF(('이 문서는 데이터 파이프라인에 관한 내용인가요? 문서: ', content)) AS is_data
FROM `my_project.wiki.documents`;
최적화 모드를 켜는 옵션 이름과 임베딩 지정 방식은 버전마다 바뀔 수 있어서, 여기서는 일부러 적지 않았습니다. 공식 문서의 "Optimize AI function costs" 항목을 확인하는 편이 안전합니다.
함께 발표된 것들 중 눈여겨본 것
AI 함수 주변으로 몇 가지가 더 있었습니다. 우리 파이프라인에 바로 연결되는 것만 골랐습니다.
- AI.PARSE_DOCUMENT: OCR, 레이아웃 파싱, 청킹을 SQL 함수 하나로 처리합니다. 위키에 첨부된 PDF를 지금은 별도 스크립트로 처리하는데, 이 단계를 통째로 걷어낼 수 있을지 보고 있습니다.
- 자동 임베딩 생성: 테이블에 행이 들어오면 임베딩을 알아서 만들어 둡니다. 최적화 모드의 전제 조건과 자연스럽게 맞물립니다.
- 하이브리드 검색: 의미 기반 검색과 전문 검색을 한 번에 합니다.
- CPU에서 도는 Gemma 임베딩: GPU 없이 임베딩을 만들어 비용을 낮춥니다.
- Python UDF: SQL로 표현하기 애매한 전처리를 BigQuery 안에서 파이썬으로 처리합니다.
무엇을 SQL로 옮기고 무엇을 남길까
정리하자면 기준은 하나였습니다. 답이 정해져 있으면 SQL로, 답을 만들어내야 하면 기존 파이프라인에.
분류와 필터는 BigQuery로 옮깁니다. 요약은 당분간 Cloud Run에 남깁니다. 요약까지 SQL로 옮길 수는 있겠지만, 프롬프트를 자주 고치는 작업이라 코드 리뷰와 버전 관리가 익숙한 파이썬 쪽이 아직은 편합니다.
옮기기 전에 꼭 해볼 것도 하나 있습니다. 문서 500건 정도를 뽑아 기존 파이썬 결과와 SQL 결과를 나란히 놓고 비교하는 겁니다. 두 결과가 다른 행만 눈으로 훑어봐도, 카테고리 정의가 애매한 지점이 금방 드러납니다. 비용을 줄이려고 시작한 일이 분류 체계를 다듬는 일로 이어지는 경우가 의외로 많습니다.
출처 및 참고자료
- Optimize AI function costs with model distillation최적화 모드(증류 모델)의 동작 방식과 제약
- The AI.CLASSIFY functionAI.CLASSIFY 문법
- 260 things we announced at Google Cloud Next '26 – a recapBigQuery AI 함수 관련 발표 항목